Artigos
Mínimos quadrados, de três maneiras
As equações normais, a QR e a SVD resolvem o mesmo problema com exatidões muito diferentes. A diferença é o quadrado de um número de condição.
O problema linear de mínimos quadrados procura os coeficientes que minimizam para uma matriz alta . Anulando o gradiente obtêm-se as equações normais,
e em NumPy ocupam uma linha:
beta = np.linalg.solve(X.T @ X, X.T @ y)Essa linha é curta, rápida e a menos exata dos três métodos habituais. Esta nota mede quanta exatidão se perde, explica porquê e diz quando a perda não importa.
Uma experiência com resposta conhecida
#O ajuste polinomial é a maneira clássica de tornar difícil um problema de mínimos quadrados. Em pontos igualmente espaçados , as colunas da base monomial tornam-se cada vez mais parecidas à medida que cresce, e a matriz aproxima-se da deficiência de característica.
Para isolar o método de resolução, escolhi o segundo membro de forma que a solução exata seja conhecida: e , com resíduo nulo. Qualquer erro em vem então da aritmética de vírgula flutuante, e não dos dados.
import numpy as np

def errors(p, m=100):
    t = np.linspace(0.0, 1.0, m)
    X = np.vander(t, p, increasing=True)
    beta = np.ones(p)
    y = X @ beta
    rel = lambda b: np.linalg.norm(b - beta) / np.linalg.norm(beta)

    normal = np.linalg.solve(X.T @ X, X.T @ y)
    Q, R = np.linalg.qr(X)
    qr = np.linalg.solve(R, Q.T @ y)
    svd = np.linalg.lstsq(X, y, rcond=None)[0]
    return np.linalg.cond(X), rel(normal), rel(qr), rel(svd)
np.linalg.qr calcula uma fatorização de Householder, e np.linalg.lstsq usa o método do LAPACK baseado na SVD. Os erros relativos nos coeficientes:
| Colunas | Número de condição | Equações normais | QR | SVD |
|---|---|---|---|---|
| 4 | ||||
| 6 | ||||
| 8 | ||||
| 10 | ||||
| 12 |
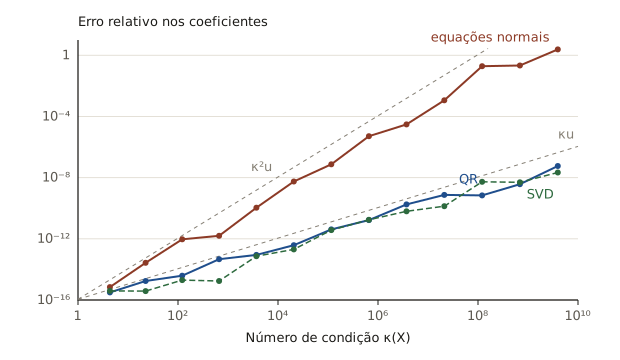
Com doze colunas, as equações normais devolvem coeficientes errados no primeiro algarismo, enquanto a QR e a SVD ainda concordam com a solução exata em oito ou nove algarismos. Representando todos os de 2 a 14 em função do número de condição, surgem duas retas com declives diferentes.
Porque é que as equações normais perdem o dobro dos algarismos
#O número de condição mede quanto uma matriz pode ampliar perturbações relativas. Formar eleva-o ao quadrado.
Um método regressivamente estável para um sistema quadrado com matriz devolve uma solução com erro relativo da ordem de , em que é a unidade de arredondamento da precisão dupla. Resolver as equações normais é uma resolução desse tipo com . A QR de Householder e a SVD nunca formam esse produto: trabalham diretamente com e, num problema de resíduo pequeno, o seu erro é da ordem de .1
As estimativas são majorantes a menos de constantes modestas, e os erros medidos ficam sobre as guias tracejadas da figura ou abaixo delas. Cada fator de dez em custa à QR cerca de um algarismo decimal e às equações normais cerca de dois.
Quando o resíduo é grande, até o melhor algoritmo herda um termo proporcional a vezes o tamanho relativo do resíduo. Esse termo pertence ao problema, e não ao método, pelo que nenhuma escolha de algoritmo o elimina.2
Quando as equações normais servem
#Nada disto torna as equações normais erradas. São a ferramenta certa mais vezes do que a tabela sugere.
- A matriz está bem condicionada. Com , as equações normais perdem cerca de quatro algarismos e ainda entregam doze. Preditores padronizados e pouco colineares estão muitas vezes nesta situação.
- Os dados não cabem em memória. e acumulam-se numa só passagem pelas linhas, em espaço , e resolvem-se no fim.
- A velocidade importa mais do que os últimos algarismos. Para , formar custa cerca de operações; a QR de Householder custa cerca de .
Mudar a base antes de mudar o método
#A correção mais barata está muitas vezes no modelo e não no algoritmo. Os monómios em são uma base notoriamente má. Levar os mesmos pontos para faz descer o número de condição da matriz de doze colunas de para , e uma base de Chebyshev em leva-o a . Nesse ponto, os três métodos concordam até ao último algarismo, e as equações normais são tão boas como qualquer outro.
A lição geral é que a exatidão se decide duas vezes: uma quando o problema é formulado, pelo número de condição, e outra quando é resolvido, consoante o algoritmo o eleve ou não ao quadrado.
Lloyd N. Trefethen e David Bau III, Numerical Linear Algebra (SIAM, 1997), lições 18 e 19, analisam o condicionamento dos problemas de mínimos quadrados e a estabilidade destes três algoritmos. ↩︎
Nicholas J. Higham, Accuracy and Stability of Numerical Algorithms, 2.ª edição (SIAM, 2002), capítulo 20, apresenta a teoria das perturbações, incluindo o termo do resíduo. ↩︎